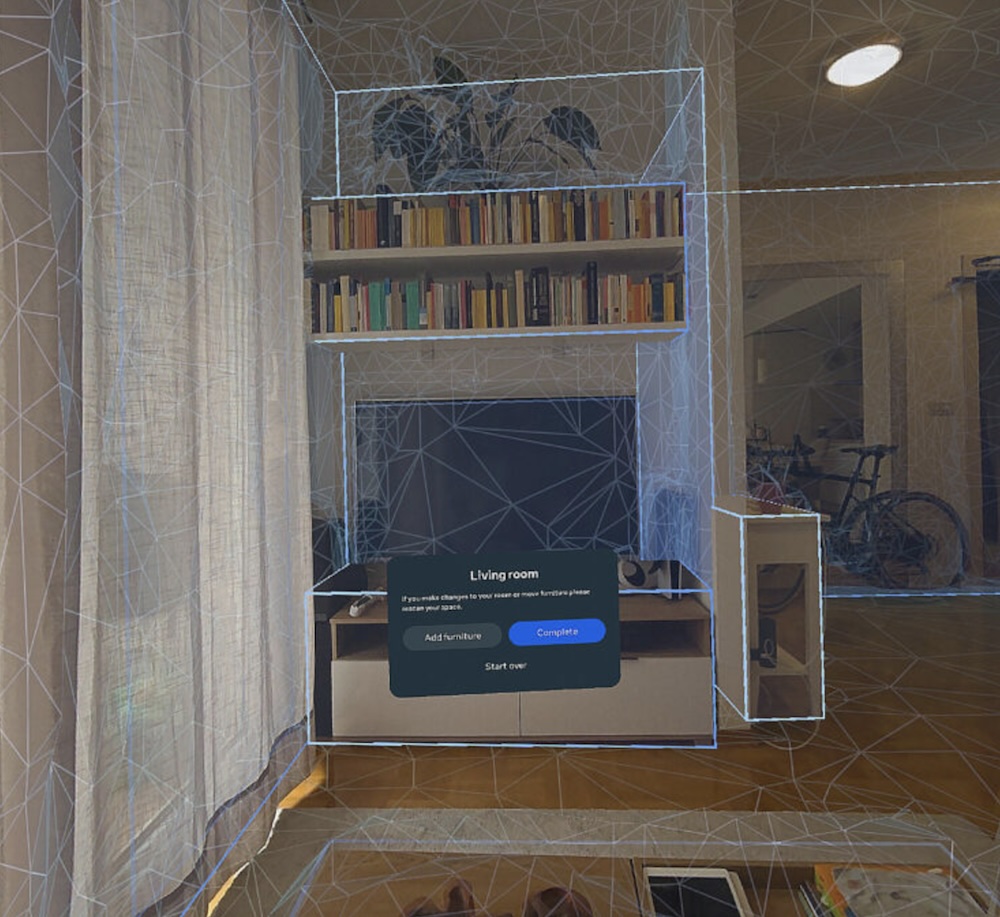
Исследователи Университета Дьюка представили RateAR — созданный для этой работы набор изображений и видео дополненной реальности, собранных в разных сценах и условиях окружающей среды. Люди оценивали три свойства виртуального контента: правильность размещения, соответствие масштаба и согласованность теней.
На этих оценках проверили 11 коммерческих мультимодальных моделей — систем, способных работать одновременно с изображениями и текстом. Максимальный показатель ранговой корреляции Спирмена составил 0,8695: его достигла GPT-5 при оценке реалистичности теней на видео. Такой показатель означает, что она почти в том же порядке расставляла сцены от худших к лучшим, что и люди. Он не показывает, совпадали ли числовые оценки модели с оценками отдельных участников.
Что проверяли с помощью RateAR
Человеческие оценки получили высокую согласованность: показатель ICC(2,5) составил 0,90 или больше. Авторы характеризуют этот уровень как хорошую или отличную надёжность. В аннотации модели и устройства не перечислены, но в полном тексте работы они названы. Авторы сравнили модели семейств Gemini, GPT, Grok и Muse Spark. Изображения сняты на Android-смартфоны, Apple Vision Pro и Microsoft HoloLens 2, а видео — на Meta Quest 3.
Авторы связывают такой подход с высокой стоимостью пользовательских исследований. В дополненной реальности на восприятие сцены влияют ограниченная геометрия, пространственные рывки и нестабильность во времени. Автоматическая оценка может помочь разработчику проверять изменения во время итераций, не собирая тестовую группу после каждого перемещения объекта или изменения его размера.
В работе отдельно названы образовательные системы, медицинские сервисы и протоколы снижения рисков. В подобных сценариях неправильно закреплённый виртуальный объект может создать более серьёзную проблему, чем в демонстрационном приложении.
Автоматическая настройка прошла проверку на 21 участнике
Во второй части исследования авторы построили систему автоматической корректировки AR-контента на основе полученных оценок. Её проверили в пользовательском исследовании с участием 21 человека.
Более 90% участников заявили, что система улучшила согласованность размещения и размера виртуального контента. Это субъективная оценка небольшой группы, а не независимое измерение точности системы.
Дополнительный анализ показал, что контекстные подсказки команды лучше согласовывались с человеческими оценками, чем другие проверенные стратегии. При этом авторы стремились учитывать визуальные признаки без чрезмерного усложнения описания задачи.
RateAR остаётся тестовым набором, созданным специально для этой работы, а человеческие оценки служат его основной точкой сравнения. Поэтому результат показывает прежде всего способность моделей повторять решения людей, а не абсолютную правильность оценки AR-сцен.
Препринт разместили на arXiv 30 сентября 2026 года. В записи указано, что работу планируют опубликовать на симпозиуме ACM VRST 2026, который пройдёт в Сендае с 16 по 18 ноября.
Источник: MIXED Reality News


Обсуждение
Добавлять комментарии могут только зарегистрированные пользователи. Регистрация или вход.